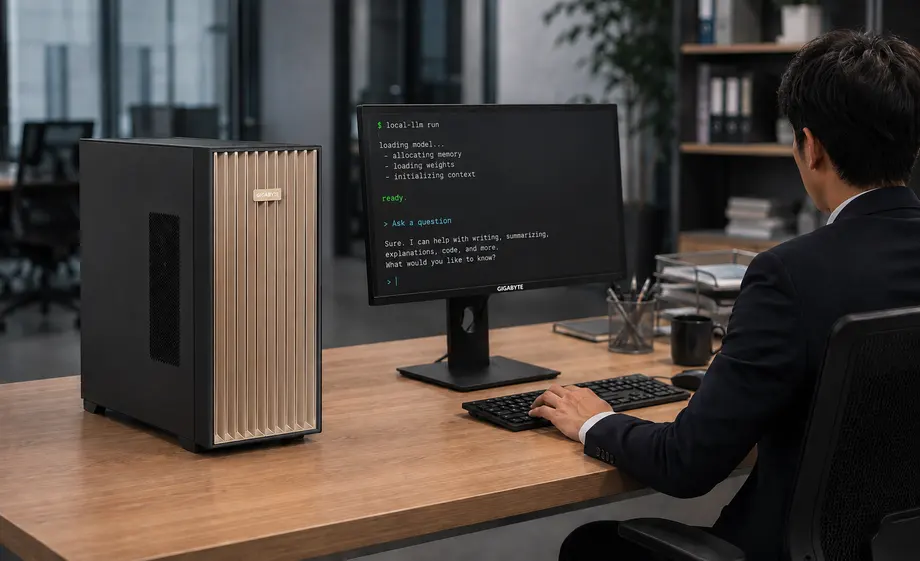
Ada titik ketika kebutuhan AI sebuah perusahaan tidak lagi nyaman ditangani oleh PC biasa, tetapi membangun satu rak server terasa terlalu jauh. Tim mungkin ingin menguji model besar, membuat asisten internal, atau mengolah dokumen sensitif tanpa terus mengirim data ke cloud. GIGABYTE W775-V10-L01 hadir tepat di ruang antara keduanya: bentuknya masih berupa tower yang dapat ditempatkan dekat meja, tetapi kemampuan komputasinya sudah masuk kelas superkomputer AI.
Di dalamnya terdapat NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip, gabungan CPU NVIDIA Grace 72-core dan GPU Blackwell Ultra. Keduanya terhubung melalui NVLink-C2C sehingga CPU dan GPU dapat bekerja dengan kumpulan memori koheren hingga 748 GB. Bagi developer, peneliti, universitas, rumah sakit, industri kreatif, dan perusahaan yang mengembangkan AI sendiri, kapasitas seperti ini membuka kemungkinan yang sebelumnya lebih identik dengan data center.
Apa yang Dimaksud dengan Superkomputer AI Lokal?
Kata “lokal” di sini bukan berarti perangkat ini dibuat di Indonesia. Maksudnya adalah model dan data dapat diproses di infrastruktur milik sendiri atau on-premises, bukan selalu dikirim ke layanan AI publik.
Bayangkan sebuah perusahaan memiliki ribuan dokumen kontrak, prosedur kerja, laporan teknis, dan pengetahuan internal. Semua data itu dapat dipakai untuk membangun sistem pencarian berbasis RAG, asisten karyawan, analisis dokumen, atau model khusus industri. Ketika prosesnya berlangsung secara lokal, organisasi memiliki kendali lebih besar atas lokasi data, versi model, hak akses, dan biaya pemakaian.
AI lokal juga bukan berarti perangkat harus berdiri sendiri. W775 dapat menjadi satu node komputasi yang dipakai beberapa orang melalui jaringan. Tim data science dapat mengaksesnya dari workstation masing-masing, sementara administrator tetap mengatur model, API, dan data dari satu lingkungan yang terkontrol.
NVIDIA GB300 dalam Format Tower
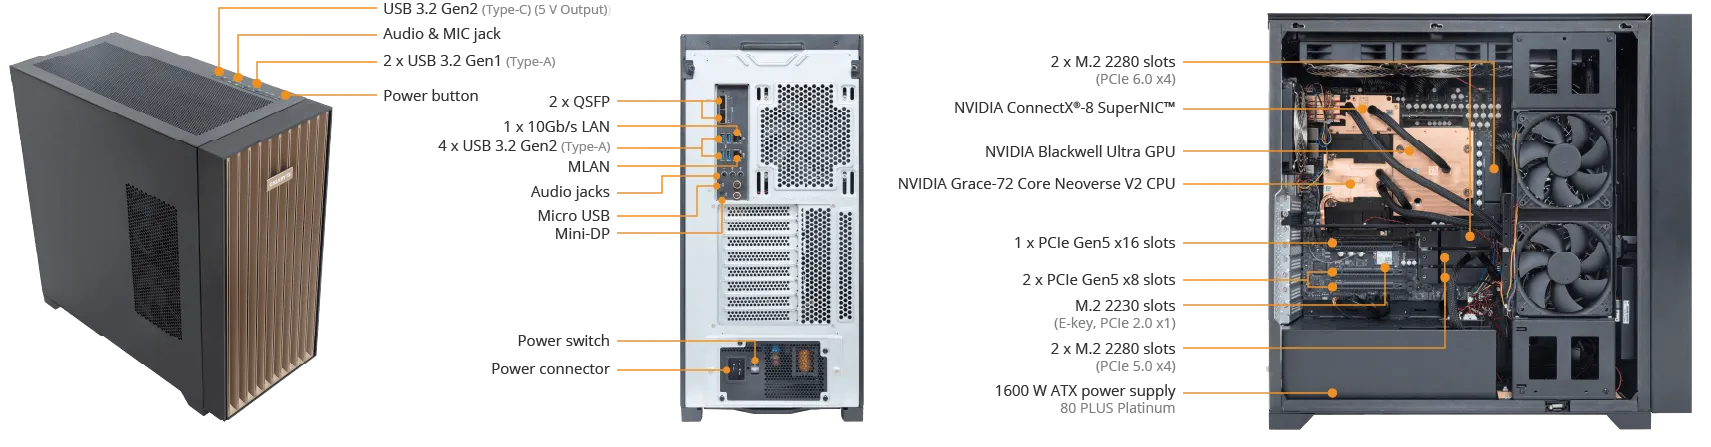
Jantung W775-V10-L01 adalah NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip. CPU Grace dan GPU Blackwell Ultra dihubungkan melalui NVLink-C2C dengan bandwidth hingga 900 GB/s. Arsitektur ini mengurangi hambatan perpindahan data antara prosesor dan akselerator dibanding sistem yang hanya mengandalkan jalur PCIe konvensional.
Spesifikasi utamanya meliputi:
| Komponen | Spesifikasi |
|---|---|
| CPU | NVIDIA Grace, 72-core Arm Neoverse V2 |
| GPU | 1× NVIDIA Blackwell Ultra |
| Memori GPU | 252 GB HBM3E, bandwidth 7,1 TB/s |
| Memori CPU | 496 GB LPDDR5X ECC, bandwidth hingga 396 GB/s |
| Total memori koheren | Hingga 748 GB |
| Performa AI | Hingga 20 PFLOPS FP4 dengan sparsity |
| Jaringan | 2× 400 Gb/s QSFP melalui ConnectX-8 dan 1× 10 GbE |
| Penyimpanan | 2× M.2 PCIe Gen6 x4 dan 2× M.2 PCIe Gen5 x4 |
| Ekspansi | 1× PCIe Gen5 x16 dan 2× PCIe Gen5 x8 |
| Pendinginan | Closed-loop liquid cooling |
| Catu daya | 1.600 watt, 80 PLUS Platinum |
Angka 20 PFLOPS terdengar mencolok, tetapi memori 748 GB justru menjadi pembeda yang lebih mudah dirasakan saat menjalankan large language model. Banyak GPU desktop sangat cepat, tetapi model besar tidak akan berjalan sepenuhnya di GPU apabila bobot model, KV cache, dan kebutuhan runtime melebihi VRAM. W775 memiliki ruang jauh lebih besar untuk menangani model dan konteks berukuran masif.
Bisa Menjalankan Model AI Sampai Berapa B?
Jawaban singkatnya: hingga 1.000B atau 1 triliun parameter untuk inference, sesuai klaim NVIDIA untuk platform DGX Station berbasis GB300 dengan memori koheren 748 GB. Karena W775-V10-L01 memakai kombinasi GB300 dan kapasitas memori yang sama, kelas kapasitas model tersebut relevan sebagai batas atas platform.
Namun, angka “B” tidak boleh dibaca sendirian. Huruf B berarti billion atau miliar parameter. Ruang memori yang dibutuhkan bergantung pada format bobot model:
| Ukuran model | Bobot FP16, perkiraan dasar | Bobot FP8, perkiraan dasar | Bobot 4-bit, perkiraan dasar |
|---|---|---|---|
| 70B | 140 GB | 70 GB | 35 GB |
| 120B | 240 GB | 120 GB | 60 GB |
| 405B | 810 GB | 405 GB | sekitar 203 GB |
| 1.000B | 2.000 GB | 1.000 GB | sekitar 500 GB |
Perhitungan tersebut hanya menggambarkan bobot model: sekitar 2 byte per parameter untuk FP16, 1 byte untuk FP8, dan 0,5 byte untuk 4-bit. Dalam penggunaan nyata masih ada overhead kuantisasi, runtime, KV cache, panjang konteks, batch, dan memori sistem. Karena itu, model 1.000B masuk akal sebagai skenario inference terkuantisasi 4-bit yang dioptimalkan, bukan sebagai janji bahwa setiap model 1.000B dapat dijalankan dengan konfigurasi apa pun.
Secara praktis, pembagiannya dapat dibaca seperti ini:
- 7B–70B: sangat lega untuk inference, RAG, agen AI, dan beberapa layanan sekaligus.
- 100B–200B: masih memberikan ruang besar untuk konteks panjang atau banyak pengguna, bergantung pada engine dan presisi.
- 400B: dapat dijalankan dengan kuantisasi yang sesuai; FP16 penuh tidak muat hanya dari perhitungan bobot dasarnya.
- Hingga 1.000B: mungkin untuk inference 4-bit yang dioptimalkan, dengan perencanaan ketat terhadap context length, KV cache, dan overhead.
GIGABYTE juga mempublikasikan pengujian yang lebih dekat dengan penggunaan sehari-hari. Dengan model NVIDIA Nemotron 3 Super 120B-A12B, platform ini disebut mampu menangani 400 permintaan bersamaan, time to first token di bawah dua detik, dan aggregate throughput mendekati 9.000 token per detik dalam kondisi uji mereka. Hasil nyata tetap dapat berubah mengikuti model, panjang prompt, jumlah token keluaran, dan konfigurasi software.
Inference, Fine-Tuning, dan Training Bukan Hal yang Sama
Istilah “menjalankan model” sering tercampur dengan “melatih model”. Padahal kebutuhan memorinya sangat berbeda.
Inference adalah memakai model yang sudah dilatih untuk menghasilkan jawaban, klasifikasi, ringkasan, gambar, atau prediksi. Inilah konteks utama dari klaim hingga 1.000B parameter.
Fine-tuning menyesuaikan model yang sudah ada dengan data dan kebutuhan tertentu. Metode hemat memori seperti LoRA atau QLoRA jauh lebih realistis dilakukan pada satu workstation daripada memperbarui seluruh parameter. Ukuran model yang nyaman akan bergantung pada framework, optimizer, panjang sequence, batch, dan bagian parameter yang dilatih.
Training dari nol membutuhkan penyimpanan bukan hanya untuk bobot, tetapi juga gradien, optimizer state, activation, checkpoint, dan data pelatihan. Secara kasar kebutuhannya dapat berkali-kali lipat dibanding inference. Jadi, W775 sangat menarik untuk eksperimen, prototyping, fine-tuning efisien, dan inference model besar, tetapi training penuh model frontier ratusan miliar parameter tetap merupakan pekerjaan klaster data center.
Manfaat Nyata untuk Tim, Bukan Sekadar Angka Benchmark
Nilai sebuah workstation AI tidak berhenti pada jumlah parameter. Dalam pekerjaan harian, manfaatnya terasa ketika tim tidak perlu menunggu antrean cloud untuk setiap eksperimen atau memindahkan dokumen sensitif keluar dari lingkungan organisasi.
Beberapa skenario yang relevan antara lain:
- asisten pengetahuan internal berbasis RAG;
- analisis kontrak, laporan keuangan, dan dokumen teknis;
- fine-tuning model untuk bahasa atau istilah khusus industri;
- computer vision untuk manufaktur, kesehatan, dan keamanan;
- simulasi, data science, dan scientific computing;
- layanan inference bersama untuk beberapa divisi;
- pengembangan AI agent yang berjalan terus-menerus.
Platform ini menggunakan Ubuntu dengan NVIDIA AI Developer Tools dan terintegrasi dengan ekosistem CUDA-X. Itu penting karena hardware berdaya besar baru benar-benar berguna ketika framework, driver, serving engine, monitoring, serta alur deployment dapat bekerja bersama.
Tetap Ada Kebutuhan Infrastruktur yang Perlu Disiapkan
Walaupun berbentuk tower, W775 bukan komputer kantor biasa. Bobot bersihnya sekitar 29,2 kg dan power supply-nya berkapasitas 1.600 watt. Spesifikasi terbaru GIGABYTE menyebut kebutuhan kabel daya C19 serta sirkuit 20 ampere untuk sistem. Kondisi kelistrikan Indonesia, tipe konektor, grounding, UPS, pendinginan ruangan, dan kecukupan jalur listrik harus diverifikasi sebelum pemasangan.
Sistem menggunakan closed-loop liquid cooling dan tiga kipas 120 mm. Untuk operasi jangka panjang, tempatkan unit di ruang yang memiliki aliran udara baik, bebas debu berlebih, serta suhu dan kelembapan terkontrol. Koneksi 10 GbE sudah berguna untuk jaringan kantor berkecepatan tinggi, sedangkan dua port 400 Gb/s ConnectX-8 memberi jalan untuk integrasi dan scale-out yang jauh lebih serius.
Siapa yang Cocok Menggunakan GIGABYTE W775-V10-L01?
W775 paling masuk akal bagi organisasi yang sudah memiliki kasus penggunaan AI yang jelas dan ingin memindahkan eksperimen menjadi layanan rutin. Perusahaan dengan data privat, kampus dengan banyak peneliti, laboratorium, instansi, penyedia layanan AI, dan tim pengembang yang menguji model besar dapat memperoleh manfaat dari kapasitas memorinya.
Untuk satu chatbot kecil 7B atau eksperimen sesekali, perangkat ini jelas berlebihan. PC dengan satu GPU, mini PC AI, atau cloud masih lebih ekonomis. W775 mulai menarik ketika model tidak lagi muat di VRAM desktop, banyak pengguna harus dilayani bersamaan, data wajib berada di lokasi sendiri, atau biaya cloud dalam jangka panjang sulit diprediksi.
Untuk gambaran anggaran, harga GIGABYTE W775-V10-L01 saat ini berkisar di angka Rp750 juta. Harga akhir dapat berubah mengikuti konfigurasi, ketersediaan unit, nilai tukar, garansi, serta kebutuhan instalasi dan dukungan teknis. Karena itu, calon pengguna sebaiknya meminta quotation terbaru sekaligus menghitung kesiapan listrik, jaringan, dan lingkungan operasional sebelum melakukan pengadaan.
Kesimpulan
GIGABYTE W775-V10-L01 membawa kemampuan yang biasanya diasosiasikan dengan server AI ke dalam format workstation tower. Kombinasi NVIDIA Grace 72-core, Blackwell Ultra, memori koheren 748 GB, performa hingga 20 PFLOPS FP4, dan jaringan ConnectX-8 membuatnya cocok untuk inference, fine-tuning efisien, data science, serta pengembangan AI lokal berskala departemen.
Kemampuannya mendukung model hingga 1.000B parameter adalah batas atas untuk inference yang dioptimalkan, bukan angka universal untuk seluruh model dan seluruh metode pelatihan. Untuk menentukan konfigurasi yang tepat, mulailah dari model yang akan dipakai, presisi atau kuantisasi, panjang konteks, target token per detik, jumlah pengguna, kapasitas storage, dan batas daya di lokasi pemasangan.
Bandung Komputer melayani konsultasi dan pengadaan workstation serta server AI untuk kebutuhan perusahaan, kampus, dan institusi. Hubungi admin untuk membahas model AI, target workload, kesiapan listrik dan jaringan, pilihan garansi, serta quotation GIGABYTE W775-V10-L01 terbaru.